


Python高级之常用的内置函数
9438 字
47 分钟
Python高级之常用的内置函数
【一】什么是内置函数?
- 内置函数就是Python给你提供的, 拿来直接用的函数,比如print,input等。
- 截止到python版本3.6.2 ,一共提供了68个内置函数,具体如下
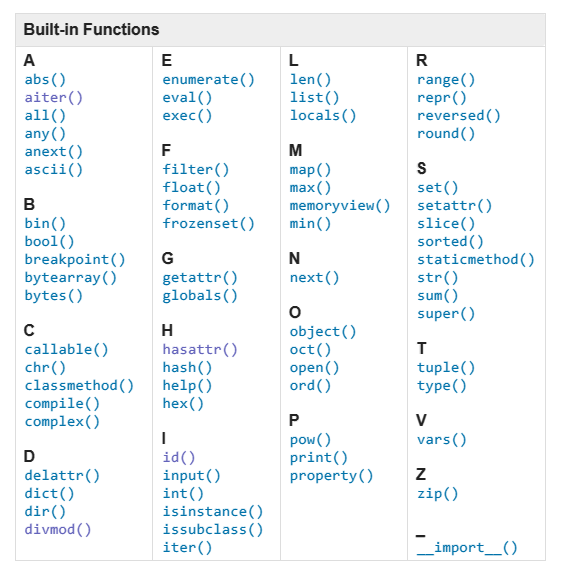
- 和数字相关
- 数据类型
- 进制转换
- 数学运算
- 和数据结构相关
- 序列
- 数据集合
- 相关内置函数
- 和作用域相关
- 和迭代器生成器相关
- 字符串类型代码的执行
- 输入输出
- 内存相关
- 文件操作相关
- 模块相关
- 帮 助
- 调用相关
- 查看内置属性
【二】数据类型转换(8)
【1】数字类型转换
(1)整数类型转换(int)
- int : 整型(整数)
# int(x) : x 转换为整数
res = '1'print(res, type(res))# 1 <class 'str'>
# 将可以转换为整数的类型转换为整数res_int = int(res)print(res_int, type(res_int))# 1 <class 'int'>(2)浮点数类型转换(float)
- float : 浮点型(小数)
# float(x) : x 转换为浮点数
start = 1print(start, type(start))# 1 <class 'int'>
start_float = float(start)print(start_float, type(start_float))# 1.0 <class 'float'>【2】字符串类型转换(str)
- str() 将数据转化成字符串
print(str(123)+'456') #123456【3】布尔类型转换(bool)
- bool: 布尔类型(True / False)
# True / False
res = 1print(res, type(res))# 1 <class 'int'>
res_bool = bool(res)print(res_bool, type(res_bool))# True <class 'bool'>
res = 0print(res, type(res))# 0 <class 'int'>
res_bool = bool(res)print(res_bool, type(res_bool))# False <class 'bool'>【4】列表类型转换(list)
- list() 将一个可迭代对象转换成列表
print(list((1,2,3,4,5,6)))
# [1, 2, 3, 4, 5, 6]【5】元祖类型转换(tuple)
- tuple() 将一个可迭代对象转换成元组
print(tuple([1,2,3,4,5,6]))
# (1, 2, 3, 4, 5, 6)【6】字典类型转换(dict)
- 字典:dict 创建一个字典
- 注释: dict() 函数可接受可迭代对象,用键值对初始化字典。
# 示例dictionary = dict([(1, 'one'), (2, 'two'), (3, 'three')])print(dictionary)# 输出:{1: 'one', 2: 'two', 3: 'three'}【7】集合类型转换(set)
- 集合:set 创建一个集合
- 注释: set() 函数用于创建一个集合,自动去除重复元素。
# 示例my_set = set([1, 2, 3, 3, 4, 5])print(my_set)# 输出:{1, 2, 3, 4, 5}【三】数学进制转换(3)
【1】十进制转二进制(bin)
- bin() 将给的参数转换成二进制
number = 10
# 十进制转二进制number_bin = bin(number)print(number_bin) # 0b1010【2】十进制转八进制(oct)
- oct() 将给的参数转换成八进制
number = 10
# 十进制转八进制number_oct = oct(number)print(number_oct) # 0o12【3】十进制转十六进制(hex)
- hex() 将给的参数转换成十六进制
number = 10
# 十进制转十六进制number_hex = hex(number)print(number_hex) # 0xa【四】数学运算(8)
(1)获取绝对值(abs)
- abs() 返回绝对值
number = -1
# 获取当前整数的绝对值number_abs = abs(number)
print(number_abs)# 1(2)获取商和余数(divmod)
- divmod() 返回商和余数
number_start = 9number_end = 4# 获取商和余数 (被除数,除数)result = divmod(number_start, number_end)print(result) # (2, 1)
# number_discuss : 商# number_remainder : 余数number_discuss, number_remainder = divmod(number_start, number_end)print(number_discuss)print(number_remainder)(3)四舍五入(round)
- round() 四舍五入
- 给定数字的四舍五入版本,有指定的小数位数。
- 默认情况下,小数点的数量是0。
- 因此,如果你调用 round() 时没有第二个参数,该函数将返回最近的整数。
# 我们可以传递一个简单的负数浮点数。# 注意我们只向函数提供一个参数,我们省略了可选的第二个参数。# 我们可以看到,对 4.51 的值为 5print(round(4.51))# 我们可以看到,对 4.50 的值为 4print(round(4.50))# 我们可以看到,对 4.49 的值为 4print(round(4.49))# 这一次我们在 round() 函数中加入了可选的第二个参数。# 这里我们把 作为第一个参数,把 1 作为第二个参数。# 我们可以看到,对 4.051 的值为 4.1print(round(4.051, 1))# 我们可以看到,对 4.050 的值为 4.0print(round(4.050, 1))# 我们可以看到,对 4.049 的值为 4.0print(round(4.049, 1))# 这一次我们在 round() 函数中加入了可选的第二个参数。# 这里我们把 作为第一个参数,把 2 作为第二个参数。# 我们可以看到,对 4.0051 的值为 4.01print(round(4.0051, 2))# 我们可以看到,对 4.0050 的值为 4.0print(round(4.0050, 2))# 我们可以看到,对 4.0049 的值为 4.0print(round(4.0049, 2))(4)a的b次幂(pow)
- pow(a, b) 求a的b次幂, 如果有三个参数. 则求完次幂后对第三个数取余
'''参数介绍: x — 数值表达式(整数或者浮点数); y — 数值表达式(整数或者浮点数); z — 数值表达式(整数或者浮点数),默认不设置z值;
返回值:返回 xy(x的y次方)的值;如果设置了z值,则再对结果进行取模,其结果等效于pow(x,y) %z;'''
pow(x, y[, z])- pow 函数常规使用print(pow(2,5)) # 等价 2*2*2*2*2 = 32print(pow(2,3)) # 等价 2*2*2 = 8print(pow(2,3,5)) # 等价 2*2*2%5 = 8 % 5 = 3print(2*2*2%5) # 等价 pow(2,3,5) = 3- pow 函数所有的参数必须是数值类型print(pow(2,'2'))
'''产生异常:
Traceback (most recent call last): File "E:/Project/python_project/untitled10/123.py", line 18, in <module> print(pow(2,'2'))TypeError: unsupported operand type(s) for ** or pow(): 'int' and 'str''''- 若果 x,y 有一个浮点数,则结果将转换为浮点数print(pow(2,3.2))print(pow(2,3.0))
'''输出结果:
9.189586839976288.0'''(5)求和(sum)
- sum() 求和
print(sum([1,2,3,4,5,6,7,8,9,10]))
# 求和:55(6)最小值(min)
- min() 求最小值
print(min(5,3,9,12,7,2))
# 求最小值:2(7)最大值(max)
- max() 求最大值
print(max(7,3,15,9,4,13))
# 求最大值:15(8)复数转换(complex)
- complex : 复数
# complex(re, im) : 具有实部 re、虚部 im 的复数。im 默认为零。
start = complex(3, 4)print(start) # (3+4j)
second = complex(5, 9)print(second) # (5+9j)
res = start + secondprint(res) # (8+13j)【五】数据结构相关(18)
【1】序列相关(5)
(1)翻转(reversed)
- reversed() 将一个序列翻转, 返回翻转序列的迭代器
lst = "你好啊"
# 不会改变原列表. 返回一个迭代器, 设计上的一个规则it = reversed(lst)
print(list(it))# ['啊', '好', '你'](2)切片(slice)
- slice() 列表的切片
lst = [1, 2, 3, 4, 5, 6, 7]
print(lst[1:3:1])# [2,3]
s = slice(1, 3, 1)# 切片用的print(lst[s])# [2,3](3)计算长度(len)
- len() 返回一个对象中的元素的个数
(4)排序(sorted)
- 语法:sorted(Iterable, key=函数(排序规则), reverse=False)
- Iterable: 可迭代对象
- key: 排序规则(排序函数), 在sorted内部会将可迭代对象中的每一个元素传递给这个函数的参数. 根据函数运算的结果进行排序
- reverse: 是否是倒叙. True: 倒叙, False: 正序
- sorted() 对可迭代对象进行排序操作 (lamda)
lst = [5, 7, 6, 12, 1, 13, 9, 18, 5]
# sort是list里面的一个方法, sort 方法没有返回值lst.sort()print(lst)# [1, 5, 5, 6, 7, 9, 12, 13, 18]
# 内置函数. 返回给你一个新列表 新列表是被排序的ll = sorted(lst)print(ll)# [1, 5, 5, 6, 7, 9, 12, 13, 18]
# 倒序l2 = sorted(lst, reverse=True)print(l2)# [18, 13, 12, 9, 7, 6, 5, 5, 1]# 根据字符串长度给列表排序lst = ['one', 'two', 'three', 'four', 'five', 'six']
def f(s): return len(s)
l1 = sorted(lst, key=f)print(l1) # ['one', 'two', 'six', 'four', 'five', 'three'](5)枚举(enumerate)
- enumerate() 获取集合的枚举对象
lst = ['one', 'two', 'three', 'four', 'five']# 把索引和元素一起获取,索引默认从0开始. 可以更改# 下面更改默认索引从 0 开始for index, el in enumerate(lst, 1): print(index) print(el)
# 1# one# 2# two# 3# three# 4# four# 5# five【2】字符串(4)
(1)格式化输出(format)
- format() 与具体数据相关, 用于计算各种小数, 精算等.
- 居中对齐方式
s = "hello world!"print(format(s, "^20")) # 居 中# hello world!print(format(s, "<20")) # 左对齐# hello world!print(format(s, ">20")) # 右对齐# hello world!- 进制转换print(format(3, 'b')) # 二进制:11print(format(97, 'c')) # 转换成unicode字符:aprint(format(11, 'd')) # ⼗进制:11print(format(11, 'o')) # 八进制:13print(format(11, 'x')) # 十六进制(⼩写字母):bprint(format(11, 'X')) # 十六进制(大写字母):Bprint(format(11, 'n')) # 和d⼀样:11print(format(11)) # 和d⼀样:11- 科学计数法print(format(123456789, 'e')) # 科学计数法. 默认保留6位小数:1.234568e+08print(format(123456789, '0.2e')) # 科学计数法. 保留2位小数(小写):1.23e+08print(format(123456789, '0.2E')) # 科学计数法. 保留2位小数(大写):1.23E+08print(format(1.23456789, 'f')) # 小数点计数法. 保留6位小数:1.234568print(format(1.23456789, '0.2f')) # 小数点计数法. 保留2位小数:1.23print(format(1.23456789, '0.10f')) # 小数点计数法. 保留10位小数:1.2345678900print(format(1.23456789e+3, 'F')) # 小数点计数法. 很大的时候输出INF:1234.567890(2)字符串转bytes(bytes)
- bytes() 把字符串转化成bytes类型
bs = bytes("今天吃饭了吗", encoding="utf-8")
print(bs)# b'\xe4\xbb\x8a\xe5\xa4\xa9\xe5\x90\x83\xe9\xa5\xad\xe4\xba\x86\xe5\x90\x97'(3)获取字节数组(bytearray)
- bytearray()
- 返回一个新字节数组. 这个数字的元素是可变的, 并且每个元素的值得范围是[0,256)
ret = bytearray("dream", encoding='utf-8')
print(ret[0])# 100
print(ret)# bytearray(b'dream')
ret[0] = 65# 把65的位置A赋值给ret[0]
print(str(ret))# bytearray(b'Aream')(4)返回对象的字符串格式(repr)
- repr() 返回一个对象的string形式
word = "今天\n吃了%s顿\t饭" % 3print(word)# 今天# 吃了3顿 饭
# 原样输出,过滤掉转义字符 \n \t \r 不管百分号%print(repr(word))# '今天\n吃了3顿\t饭'【3】字符编码(3)
(1)字符编码找数字(ord)
- ord() 输入字符找带字符编码的位置
print(ord('a'))# 字母a在编码表中的码位:97
print(ord('中'))# '中'字在编码表中的位置:20013(2)数字找字符编码(chr)
- chr() 输入位置数字找出对应的字符
print(chr(65))# 已知码位,求字符是什么:A
print(chr(19999))# 丟(3)数字找ASCII码(ascii)
- ascii() 是ascii码中的返回该值 不是就返回u
for i in range(65536): #打印出0到65535的字符 print(chr(i), end=" ")
print(ascii("@")) #'@'【4】数据集合(1)
- 创建一个冻结的集合(frozenset)
- frozenset() 创建一个冻结的集合,冻结的集合不能进行添加和删除操作。
- 注释: frozenset() 函数返回一个不可变的 frozenset 对象,适用于作为字典的键或集合的元素。
# 示例frozen_set = frozenset([1, 2, 3, 4, 5])print(frozen_set)# 输出:frozenset({1, 2, 3, 4, 5})【5】判断条件(2)
(1)所有为真(all)
- all() 可迭代对象中全部是True, 结果才是True
print(all([1,'hello',True,9])) #True(2)任意为真(any)
- any() 可迭代对象中有一个是True, 结果就是True
print(any([0,0,0,False,1,'good'])) #True【6】高阶函数(3)
(1)打包(zip)
- zip() 函数
- 用于将可迭代的对象作为参数
- 将对象中对应的元素打包成一个元组
- 然后返回由这些元组组成的列表.
- 如果各个迭代器的元素个数不一致, 则返回列表长度与最短的对象相同
lst1 = [1, 2, 3, 4, 5, 6]lst2 = ['醉乡民谣', '驴得水', '放牛班的春天', '美丽人生', '辩护人', '被嫌弃的松子的一生']lst3 = ['美国', '中国', '法国', '意大利', '韩国', '日本']print(zip(lst1, lst1, lst3)) # <zip object at 0x00000256CA6C7A88>
# 将三组列表打包成 一对一 的元祖# 如果少则按最少算for el in zip(lst1, lst2, lst3): print(el)
# (1, '醉乡民谣', '美国')# (2, '驴得水', '中国')# (3, '放牛班的春天', '法国')# (4, '美丽人生', '意大利')# (5, '辩护人', '韩国')# (6, '被嫌弃的松子的一生', '日本')(2)过滤(filter)
- 语法:fiter(function. Iterable)
- function: 用来筛选的函数.
- 在filter中会自动的把iterable中的元素传递给function.
- 然后根据function返回的True或者False来判断是否保留留此项数据
- Iterable: 可迭代对象
- function: 用来筛选的函数.
- filter() 过滤 (lamda)
def func(i): # 判断奇数 return i % 2 == 1
lst = [1, 2, 3, 4, 5, 6, 7, 8, 9]
# l1是迭代器l1 = filter(func, lst)print(l1) # <filter object at 0x000001CE3CA98AC8>print(list(l1))# [1, 3, 5, 7, 9](3)映射(map)
- 语法 : map(function, iterable)
- 可以对可迭代对象中的每一个元素进行映射. 分别去执行 function
- map() 会根据提供的函数对指定序列列做映射(lamda)
def f(i): return i
lst = [1, 2, 3, 4, 5, 6, 7, ]# 把可迭代对象中的每一个元素传递给前面的函数进行处理.# 处理的结果会返回成迭代器print(list(it))
it = map(f, lst)print(it) # <map object at 0x000001EEDDE997B0>
# 如果要查看 map 的结果需要用 list 强转print(list(it))# [1, 2, 3, 4, 5, 6, 7]【六】作用域(2)
- locals() 返回当前作用域中的名字
- globals() 返回全局作用域中的名字
name = "dream"
def func(): a = 10 # 当前作用域中的内容 print(f"这是当前作用域中的内容 :>>>> {locals()}") # 全局作用域中的内容 print(f"这是全局作用域中的内容 :>>>> {globals()}")
print("我是函数func内部")
func()# 这是当前作用域中的内容 :>>>> {'a': 10}
# 这是全局作用域中的内容 :>>>> {'__name__': '__main__', '__doc__': None, '__package__': None, '__loader__': <_frozen_importlib_external.SourceFileLoader object at 0x000002687A368910>, '__spec__': None, '__annotations__': {}, '__builtins__': <module 'builtins' (built-in)>, '__file__': 'E:\\PythonProjects\\09Python的内置函数\\01start.py', '__cached__': None, 'name': 'dream', 'func': <function func at 0x000002687A3D35B0>}
# 我是函数func内部【七】迭代器生成器(3)
【1】循环生成数据(range)
- range() 生成数据
print(range(1, 10))# range(1, 10)
print([i for i in range(1, 10)])# [1, 2, 3, 4, 5, 6, 7, 8, 9]【2】获取迭代器(iter)
- iter()
- 获取迭代器, 内部实际使用的是** iter**()方法来获取迭代器
lst = [1, 2, 3, 4, 5]
# __iter__()获得迭代器it = iter(lst)print(it)# <list_iterator object at 0x0000016162EC97B0>【3】向下执行(next)
- next()
- 迭代器向下执行一次, 内部实际使用了** next**()方法返回迭代器的下一个项目
lst = [1, 2, 3, 4, 5]
# __iter__()获得迭代器it = iter(lst)print(it)# <list_iterator object at 0x0000016162EC97B0>print(next(it))# 1print(next(it))# 2print(next(it))# 3print(next(it))# 4print(next(it))# 5【八】字符串类型代码的执行(3)
【1】指定指令并返回结果(eval)
- eval() 执行字符串类型的代码. 并返回最终结果
s1 = input("请输入a+b:")# 输入:8+9
# 可以动态的执行代码. 代码必须有返回值print(eval(s1))# 17【2】指定指令不返回结果(exec)
- exec() 执行字符串类型的代码
s2 = "for i in range(5): print(i)"# exec 执行代码不返回任何内容a = exec(s2)# 0# 1# 2# 3# 4print(a) # None
# 动态执行代码exec("""def func(): print(" 我是周杰伦")""")func() # 我是周杰伦【3】编码指令
- compile() 将字符串类型的代码编码. 代码对象能够通过exec语句来执行或者eval()进行求值
code1 = "for i in range(3): print(i)"# compile并不会执行你的代码.只是编译com = compile(code1, "", mode="exec")# 执行编译的结果exec(com)# 0# 1# 2code2 = "5+6+7"com2 = compile(code2, "", mode="eval")print(eval(com2))# 18code3 = "name = input('请输入你的名字:')"# 输入:hello
com3 = compile(code3, "", mode="single")exec(com3)print(name) # hello【九】输入输出(2)
- print() : 打印输出
print("hello", "world", sep="*", end="@")# sep:打印出的内容用什么连接# end:以什么为结尾# hello*world@- input() : 获取用户输出的内容
【十】算法(1)
- hash() :
- 获取到对象的哈希值(int, str, bool, tuple).
s = 'dream'print(hash(s))# 1612413944648601058- 列表不允许hashlst = [1, 2, 3, 4, 5]print(hash(lst))# 报错,列表是不可哈希的r'''Traceback (most recent call last): File "E:\PythonProjects\09Python的内置函数\01start.py", line 361, in <module> print(hash(lst)) # 报错,列表是不可哈希的TypeError: unhashable type: 'list''''- hash算法:
- (1) 目的是唯一性
- (2) dict 查找效率非常高
- hash表:
- 用空间换的时间 比较耗费内存
【十一】文件操作(1)
- open() : 用于打开一个文件, 创建一个文件句柄
f = open('file',mode='r',encoding='utf-8')f.read()f.close()【十二】导入模块(1)
- import() : 用于动态加载类和函数
# 让用户输入一个要导入的模块name = input("请输入你要导入的模块:")json = __import__(name)# 可以动态导入模块print(json.dumps({"name": "dream"}))
# {"name": "dream"}【十三】帮助(1)
- help() : 函数用于查看函数或模块用途的详细说明
# 查看字符串的用途print(help(str))【十四】调度相关(1)
- callable() : 用于检查一个对象是否是可调用的
- 如果返回True, object有可能调用失败
- 但如果返回False. 那调用绝对不会成功
a = 10# 变量a不能被调用
print(callable(a))# False
def f(): print("hello")
# 函数是可以被调用的print(callable(f))# True【十五】查看内置属性(1)
- dir() :
- 查看对象的内置属性
- 访问的是对象中的 dir() 方法
# 查看元组的方法print(dir(tuple))【十六】异步迭代函数(aiter)
- aiter()函数 - py3.10+
- 语法:aiter(async_iterable)
- 其中 async_iterable 是一个异步可迭代对象,相当于调用 x.aiter()。
- 注意:与 iter() 不同,aiter() 没有两个参数的版本。
- aiter() 和 anext() 调用对象的 aiter() 和 anext()
- 它们本质上是 iter() 和 next() 的异步等价物。
- 在大多数情况下,很少需要直接使用新的内置函数, 我们可以直接用async for代替。
- async for 循环已经隐式调用了类的 aiter 和 anext 方法。
【1】应用
- 如果您正在编写的代码以某种方式与异步迭代器交互,那么您只需要显式使用 aiter 和 anext,而这种方式不被 async for 循环直接支持。
- 例如,这是一个异步生成器,它从给定的可迭代对象中产生成对的值:
async def pairwise(aiterable, default=None): # 获取对迭代器的引用 ait = aiter(aiterable) # 得到一个额外的值,产生一个 2 元素元组 async for x in ait: yield x, await anext(ait, default)- 如果您在 main 函数中循环使用 pairwise(AIter(10)),您会发现它现在打印数字元组
- 例如 finally (0, 1)。
- 在每个元组之前
- 您将看到由迭代器类打印的两组开始行和结束行
- 一组用于最终出现在配对结果中的每个值。
【2】示例
import asyncio
async def numbers(nums): for i in range(nums): yield i await asyncio.sleep(0.5)
# 隐式使用[i async for i in numbers(10) if i % 2 == 0]# 显式使用[i async for i in aiter(numbers(10)) if i % 2 == 0]# [0, 2, 4, 6, 8]
a = aiter(numbers(10))dir(a)'''['__aiter__', '__anext__', '__class__',...'''- 在上面的代码中,numbers() 函数是一个异步生成器,它为异步列表理解生成值。
【十七】next异步变体(anext)
- anext()- py3.10+
【1】作用
- anext() 是 Python 3.10 版本中的一个新函数。
- 它在等待时从异步迭代器返回下一项
- 如果给定并且迭代器已用尽
- 则返回默认值。
- 这是 next() 内置的异步变体,行为类似。
【2】语法
- awaitable anext(async_iterator[, default])
- 其中 async_iterator 是一个异步迭代器。
- 它接受一个可选参数,当迭代器耗尽时返回。
- 当进入 await 状态时
- 从给定异步迭代器(asynchronous iterator)返回下一数据项
- 迭代完毕则返回 default。
- 这是内置函数next() 的异步版本,类似于调用 async_iterator 的anext() 方法,返回一个 awaitable,等待返回迭代器的下一个值。
- 若有给出 default 则在迭代完毕后会返回给出的值
- 否则会触发 StopAsyncIteration。
【3】示例
import asyncio
class CustomAsyncIter: def __init__(self): self.iterator = iter(['A', 'B']) def __aiter__(self): return self async def __anext__(self): try: x = next(self.iterator) except StopIteration: raise StopAsyncIteration from None await asyncio.sleep(1) return x
async def main1(): iter1 = CustomAsyncIter() print(await anext(iter1)) # Prints 'A' print(await anext(iter1)) # Prints 'B' print(await anext(iter1)) # Raises StopAsyncIteration
async def main2(): iter1 = CustomAsyncIter() print('Before') # Prints 'Before' print(await anext(iter1, 'Z')) # Silently terminates the script!!! print('After') # This never gets executed
asyncio.run(main1())'''ABraise StopAsyncIteration'''
asyncio.run(main2())'''BeforeAAfter'''【十八】调试器(breakpoint)
- breakpoint()函数 - 3.7+
【1】作用
- Python 3.7添加了breakpoint(),此函数将您放入调用站点的调试器中。
- 具体来说,它调用sys.breakpointhook(),直接传递args和kws。
- 默认情况下,sys.breakpointhook()调用pdb.set_trace(),不需要参数。
- 在这种情况下,它纯粹是一个方便的函数,因此您不必显式地导入pdb或键入足够多的代码来进入调试器。
- 但是,sys.breakpointhook()可以设置为其他函数,breakpoint()将自动调用该函数,允许您进入所选的调试器。
【2】语法
- breakpoint(*args, **kws)
- 参数介绍:
- *args, **kws---不定长参数
- 返回值:
- 下面例子展示 breakpoint()函数使用方法
【3】示例
# 以前foo()import pdb; pdb.set_trace()bar()
# 现在foo()breakpoint()bar()- *args, **kws --- 不定长参数区别
def f(arg,*args,**kwargs): print(arg,args,kwargs)f(1,2,4,5,a=1,b=2)
# 1 (2, 4, 5) {'a': 1, 'b': 2}【十九】类的静态方法(classmethod)
- classmethod()函数
【1】作用
- 将方法转换为类方法。
- 类方法将类作为隐式第一个参数接收,就像实例方法接收实例一样。
- 类方法可以在类(如c.f())上调用,也可以在实例(如c().f())上调用。
- 除了类之外,实例被忽略。
- 如果为派生类调用了类方法,则派生类对象将作为隐含的第一个参数传递。
- 类方法不同于C++或Java静态方法。
- 也就是说,classmethod修饰符对应的函数不需要实例化,不需要 self 参数,但第一个参数需要是表示自身类的 cls 参数,可以来调用类的属性,类的方法,实例化对象。
【2】语法
class C: @classmethod def f(cls, arg1, arg2, ...): ...【3】示例
- 返回值:
- 返回函数的类方法
- 下面例子展示classmethod()函数函数使用方法
class B(object): num = 10 def func1(self): print('self') @classmethod def func2(cls): print('func2') print(cls.num) cls().func1()B.func2() # 不需要实例化
# func2# 10# self【二十】Python中的反射机制(4)
【1】什么是反射
- 反射指在程序运行过程中可以动态获取对象的信息。
- 是通过字符串的形式,导入模块;
- 通过字符串的形式,去模块寻找指定函数,并执行。
- 利用字符串的形式去对象中操作成员,一种基于字符串的驱动。
【2】Python反射中的内置函数
(1)getattr()
- getattr():
- 用于获取对象中的属性
- 但是其不能获取私有变量也就是最前面带__的属性或方法
getattr(object,name,default)其有三个参数
- object<对象>
- name<对象中的属性值>
- default<可选> 该对象中不存在该属性的时候的返回值。
- 示例
class Person(): def __init__(self, name, age): self.name = name self.age = age
def run(self): print(f'这人 {self.name} 能跑!')
if __name__ == '__main__': person = Person("dream", 18) # 对 person 反射,是否存在 name 属性,存在则为该值,不存在则为默认值 not found res_name = getattr(person, 'name', 'not found') print(res_name) # 输出:dream
# 对 person 反射,是否存在 cc 属性,存在则为该值,不存在则为默认值 not found res_cc = getattr(person, 'cc', 'not found') print(res_cc) # 输出:not found
# 对 person 反射,是否存在 run 方法,存在则为该对象地址,不存在则为默认值 None func = getattr(person, 'run', None) print(func) # 输出:<bound method Person.run of <__main__.Person object at 0x0000029D180AB9A0>> # 映射出来的 函数内存地址可以直接调用 func() # 输出:这人 dream 能跑!(2)hasattr()
- hasattr(object,name)
- 该函数用于检测对象(object)中是否含有name(指的是某个属性名而并不是指name)这个属性
- 其中object是对象
- name是指需要检查该对象中是否存在的属性的名称。
- 该函数用于检测对象(object)中是否含有name(指的是某个属性名而并不是指name)这个属性
- 示例
class Person(): def __init__(self, name, age): self.name = name self.age = age
def run(self): print(f'这人 {self.name} 能跑!')
if __name__ == '__main__': person = Person("dream", 18) # 对 person 反射,是否存在 name 属性,存在则为True,不存在则为False res_name = hasattr(person, 'name') print(res_name) # 输出:True res_sex = hasattr(person, 'sex') print(res_sex) # 输出:False(3)setattr()
- setattr(object,name,value)
- 是指给某个对象某个属性设置指定的值
- object是对象
- name是对象中的属性名
- value是你想要设的值。
- 其中三个参数都是必须的填的。
- 是指给某个对象某个属性设置指定的值
- 该函数可以给对象增加新的属性并且可以将对象中的方法改变。
- 示例
class Person(): def __init__(self, name, age): self.name = name self.age = age
def run(self): print(f'这人 {self.name} 能跑!')
if __name__ == '__main__': person = Person("dream", 18) # 对 person 反射,是否存在 name 属性,存在则为True,不存在则为False res_name_one = hasattr(person, 'sex') print(res_name_one) # False
# 向对象中添加属性 setattr(person, 'sex', '男')
res_name_two = hasattr(person, 'sex') print(res_name_two) # True(4)delattr()
- delattr(object,name)
- 指删除对象中的指定属性
- 其中object是对象
- name是对象中的属性名。
- 指删除对象中的指定属性
- 示例
class Person(): def __init__(self, name, age): self.name = name self.age = age
def run(self): print(f'这人 {self.name} 能跑!')
if __name__ == '__main__': person = Person("dream", 18) # 对 person 反射,是否存在 name 属性,存在则为True,不存在则为False res_name_one = hasattr(person, 'name') print(res_name_one) # True
# 向对象中添加属性 delattr(person, 'name')
res_name_two = hasattr(person, 'name') print(res_name_two) # False- 我在这里再补充说明下dir() 这个函数:
- dir()不带变量时候用于获取当前范围内的变量、方法和定义的类型列表;
- 带参数时返回参数的属性、方法列表。
- dir(object) object<对象>、变量、类型
- 以上就是python反射中的四个内置函数。
【3】Python反射的应用
- 反射的一个应用就是web框架中url路由
- 用户通过输入url路由就可以定位到views视图中的函数
- 这里面主要应用了getattr() 这个函数(一个用于获取views视图中对应函数)
- 如果没有就返回你设定的值以此判断是否可以往下执行。
【二十一】判断内存空间地址(id)
【1】作用
- 在Python中,id()函数用于返回一个对象的唯一标识符。
- 这个标识符是一个整数,代表了该对象在内存中的地址。
- 换句话说,每个对象都有一个唯一的标识符,即使它们的值相同也是如此。
【2】语法
id(object)
# 其中,object是要返回标识符的对象。【3】示例
a = 5b = 5print("a的标识符为:", id(a))print("b的标识符为:", id(b))
# a的标识符为: 140707288191088# b的标识符为: 140707288191088- 可以看到,即使a和b的值相同,它们的标识符也相同,这是因为它们指向的是同一个内存地址。
【二十二】检查对象类型(isinstance)
【1】作用
- 这个函数有点类似type函数的定义
- type判断 函数类型是什么
- 而isinstance是 通过判断对象是否是已知的类型
- 但是isinstance比type高级一些(功能上的差异)
- 具体差异:
- type()
- 不考虑继承关系(子类不是父类类型)
- isinstance()
- 考虑继承关系(子类是父类类型)
- type()
【2】语法
(1)官方文档
def isinstance(x, A_tuple): # real signature unknown; restored from __doc__ """ Return whether an object is an instance of a class or of a subclass thereof.
A tuple, as in ``isinstance(x, (A, B, ...))``, may be given as the target to check against. This is equivalent to ``isinstance(x, A) or isinstance(x, B) or ...`` etc. """ pass- isinstance(object, classinfo)
- object :实例对象
- classinfo :类型可以是 直接或间接类名、基本类型以及元组
(2)说人话
tmp = 2isinstance(tmp,int) # 结果返回 Trueisinstance(tmp,str) # 结果返回 False
tmp2 = {"a":19} #定义一个dict类型的变量isinstance(tmp2,dict) # 结果返True- 通过以上实例,我们可以看到isinstance()基本用法为:isinstance(object,classinfo)
- 其中参数:
- object : 实例对象。
- classinfo : 可以是直接或者间接类名、基本类型或者由它们组成的元组。
- 返回值:
- 如果对象(object)的类型与参数(classinfo)的类型相同则返回 True,否则返回 False。
- 其中参数:
【3】函数版用法
(1)基础版
a = 10086isinstance (a,int) # true
isinstance (a,str) # false
isinstance (a,(str,int,list))# 只要满足元组类型中的其中一个即可,答案是满足,所以为true(2)进阶版
s = () # 定义一个元组类型isinstance(s,tuple) # trueisinstance(s,list) # false
s1 = [] # 定义一个列表类型isinstance(s1,list) # true
s2 = {} # 定义一个字典类型isinstance(s2,dict) # true
# 混合类型判断,通过for索引取值判断isinstance(s,(tuple,list,dict))【二十三】检查类类型(issubclass)
【1】作用
- Python 提供了如下两个函数来检查类型:
- issubclass(cls, class_or_tuple):
- 检查 cls 是否为后一个类或元组包含的多个类中任意类的子类。
- isinstance(obj, class_or_tuple):
- 检查 obj 是否为后一个类或元组包含的多个类中任意类的对象。
- issubclass(cls, class_or_tuple):
- 通过使用上面两个函数,程序可以方便地先执行检查,然后才调用方法,这样可以保证程序不会出现意外情况。
- 如下程序示范了通过这两个函数来检查类型:
# 定义一个字符串hello = "Hello";# "Hello"是str类的实例,输出Trueprint('"Hello"是否是str类的实例: ', isinstance(hello, str))# "Hello"是object类的子类的实例,输出Trueprint('"Hello"是否是object类的实例: ', isinstance(hello, object))# str是object类的子类,输出Trueprint('str是否是object类的子类: ', issubclass(str, object))# "Hello"不是tuple类及其子类的实例,输出Falseprint('"Hello"是否是tuple类的实例: ', isinstance(hello, tuple))# str不是tuple类的子类,输出Falseprint('str是否是tuple类的子类: ', issubclass(str, tuple))
# 定义一个列表my_list = [2, 4]# [2, 4]是list类的实例,输出Trueprint('[2, 4]是否是list类的实例: ', isinstance(my_list, list))# [2, 4]是object类的子类的实例,输出Trueprint('[2, 4]是否是object类及其子类的实例: ', isinstance(my_list, object))# list是object类的子类,输出Trueprint('list是否是object类的子类: ', issubclass(list, object))# [2, 4]不是tuple类及其子类的实例,输出Falseprint('[2, 4]是否是tuple类及其子类的实例: ', isinstance([2, 4], tuple))# list不是tuple类的子类,输出Falseprint('list是否是tuple类的子类: ', issubclass(list, tuple))- 通过上面程序可以看出
- issubclass() 和 isinstance() 两个函数的用法差不多
- 区别只是
- issubclass() 的第一个参数是类名
- 而 isinstance() 的第一个参数是变量
- 这也与两个函数的意义对应:
- issubclass 用于判断是否为子类,
- 而 isinstance() 用于判断是否为该类或子类的实例。
issubclass() 和 isinstance() 两个函数的第二个参数都可使用元组。例如如下代码:data = (20, 'fkit')print('data是否为列表或元组: ', isinstance(data, (list, tuple))) # True# str不是list或者tuple的子类,输出Falseprint('str是否为list或tuple的子类: ', issubclass(str, (list, tuple)))# str是list或tuple或object的子类,输出Trueprint('str是否为list或tuple或object的子类 ', issubclass(str, (list, tuple, object)))【二十四】内存查看对象(memoryview)
【1】作用
- memoryview() 函数返回给定参数的内存查看对象(memory view)。
- 所谓内存查看对象
- 是指对支持缓冲区协议的数据进行包装
- 在不需要复制对象基础上允许Python代码访问。
【2】语法
- memoryview(obj)
- obj : 对象
- 返回值 : 返回元组列表。
【3】示例
v = memoryview(bytearray("abcefg", 'utf-8'))print(v[1])# 98print(v[-1])# 103print(v[1:4])# <memory at 0x10f543a08>print(v[1:4].tobytes())# b'bce'【二十五】基类(object)
【1】作用
- Object类是Python中所有类的基类
- 如果定义一个类时没有指定继承哪个类,则默认继承object类。
- object没有定义dict
- 所以不能对object类实例对象尝试设置属性。
【2】语法
- object()
- 返回值:
- 返回一个新的无特征对象
【3】示例
class A: passprint(issubclass(A,object)) #默认继承object类
print(dir(object)) #object类定义了所有类的一些公共方法
# True# ['__class__', '__delattr__', '__dir__', '__doc__', '__eq__', '__format__', '__ge__', '__getattribute__', '__gt__', '__hash__', '__init__', '__init_subclass__', '__le__', '__lt__', '__ne__', '__new__', '__reduce__', '__reduce_ex__', '__repr__', '__setattr__', '__sizeof__', '__str__', '__subclasshook__']- object没有定义dict
- 所以不能对object类实例对象尝试设置属性
# 定义一个类Aclass A: passa = A()a.name = 'li' # 能设置属性
b = object()b.name = 'wang' # 不能设置属性
# Traceback (most recent call last):# File "D:/Pythonproject/111/object.py", line 14, in <module># b.name = 'wang' # 不能设置属性#AttributeError: 'object' object has no attribute 'name'【二十六】类的装饰器(property)
【1】property 应用场景
- 在获取、设置和删除对象属性的时候,需要额外做一些工作。
- 比如在游戏编程中,设置敌人死亡之后需要播放死亡动画。
- 需要限制对象属性的设置和获取。
- 比如用户年龄为只读,或者在设置用户年龄的时候有范围限制。
- 这时就可以使用 property 工具,它把方法包装成属性,让方法可以以属性的形式被访问和调用。
【2】property() 函数
- 语法property(fget=None, fset=None, fdel=None, doc=None) -> property attribute
- fget 是获取属性值的方法。
- fset 是设置属性值的方法。
- fdel 是删除属性值的方法。
- doc 是属性描述信息。如果省略,会把 fget 方法的 docstring 拿来用(如果有的话)
【3】示例
class Student: def __init__(self): self._age = None
def get_age(self): print('获取属性时执行的代码') return self._age
def set_age(self, age): print('设置属性时执行的代码') self._age = age
def del_age(self): print('删除属性时执行的代码') del self._age
age = property(get_age, set_age, del_age, '学生年龄')
student = Student()# 注意要用 类名.属性.__doc__ 的形式查看属性的文档字符串print('查看属性的文档字符串:' + Student.age.__doc__)"""查看属性的文档字符串:学生年龄"""
# 设置属性student.age = 18"""设置属性时执行的代码"""
# 获取属性print('学生年龄为:' + str(student.age))"""获取属性时执行的代码学生年龄为:18"""
# 删除属性del student.age"""删除属性时执行的代码"""【4】@property 装饰器
- @property 语法糖提供了比 property() 函数更简洁直观的写法。
- 被 @property 装饰的方法是获取属性值的方法,被装饰方法的名字会被用做 属性名。
- 被 @属性名.setter 装饰的方法是设置属性值的方法。
- 被 @属性名.deleter 装饰的方法是删除属性值的方法。
【5】示例(等价于 property()函数 )
class Student: def __init__(self): self._age = None
@property def age(self): print('获取属性时执行的代码') return self._age
@age.setter def age(self, age): print('设置属性时执行的代码') self._age = age
@age.deleter def age(self): print('删除属性时执行的代码') del self._age
student = Student()
# 设置属性student.age = 18"""设置属性时执行的代码"""
# 获取属性print('学生年龄为:' + str(student.age))"""获取属性时执行的代码学生年龄为:18"""
# 删除属性del student.age"""删除属性时执行的代码"""【6】特别注意
- 可以省略设置属性值的方法,此时该属性变成只读属性。如果此时仍然设置属性,会抛出异常 AttributeError: can’t set attribute。
- 如果报错 RecursionError: maximum recursion depth exceeded while calling a Python object,很可能是对象属性名和 @property 装饰的方法名重名了,一般会在对象属性名前加一个下划线 _ 避免重名,并且表明这是一个受保护的属性。
【二十七】超类(super)
【1】作用
- super也是一个类,是的。他不是一个方法也不是一个内置的关键字。
class A: pass
print(type(super(A)))
# <class 'super'>- 直接通过查看super的源码也可以看出它是一个类
class super(object): """ super() -> same as super(__class__, <first argument>) super(type) -> unbound super object super(type, obj) -> bound super object; requires isinstance(obj, type) super(type, type2) -> bound super object; requires issubclass(type2, type) Typical use to call a cooperative superclass method: class C(B): def meth(self, arg): super().meth(arg) This works for class methods too: class C(B): @classmethod def cmeth(cls, arg): super().cmeth(arg) """ def __getattribute__(self, *args, **kwargs): # real signature unknown """ Return getattr(self, name). """ pass
def __get__(self, *args, **kwargs): # real signature unknown """ Return an attribute of instance, which is of type owner. """ pass
def __init__(self, type1=None, type2=None): # known special case of super.__init__ """ super() -> same as super(__class__, <first argument>) super(type) -> unbound super object super(type, obj) -> bound super object; requires isinstance(obj, type) super(type, type2) -> bound super object; requires issubclass(type2, type) Typical use to call a cooperative superclass method: class C(B): def meth(self, arg): super().meth(arg) This works for class methods too: class C(B): @classmethod def cmeth(cls, arg): super().cmeth(arg)
# (copied from class doc) """ pass
@staticmethod # known case of __new__ def __new__(*args, **kwargs): # real signature unknown """ Create and return a new object. See help(type) for accurate signature. """ pass
def __repr__(self, *args, **kwargs): # real signature unknown """ Return repr(self). """ pass
__self_class__ = property(lambda self: type(object)) """the type of the instance invoking super(); may be None
:type: type """
__self__ = property(lambda self: type(object)) """the instance invoking super(); may be None
:type: type """
__thisclass__ = property(lambda self: type(object)) """the class invoking super()
:type: type """【2】错误纠正
- 纠正(super****就是用来调用父类方法的,这是一个错误的观点!)
class A: def __init__(self): print("A")
class B(A): def __init__(self): print("B") super().__init__()
class C(A): def __init__(self): print("C") super().__init__()
class D(B, C): def __init__(self): print("D") super().__init__()
D()
# D# B# C# A- 如果按照“super就是用来调用父类的方法的”这样的理解来看,那上述代码的执行的过程应该为:
- print(“D”)
- 【调用super会先后执行B和C】
- 先执行B:print(“B”)
- 【调用super执行A】
- print(“A”)
- 【调用super会先后执行B和C】
- 后执行C:print(“C”)
- 【调用super执行A】
- print(“A”)
- 执行结果理论应该为:D B A C A
- 但实际情况却是:D B C A
- 所以说“super就是用来调用父类的方法的”这个说法是错误的!
- 实际上super的调用是遵循Python的【MRO(方法解析顺序)】来执行的,在Python3中,MRO是基于C3算法来实现的。
【3】使用场景
(1)场景一
- 1.假如我们继承的多个父类有同名的方法
- 可以使用super来指定使用哪个父类的方法
class A: def test(self): print('A')
class B: def test(self): print('B')
class C(A, B): def __init__(self): super().test() # 调用A类中的test方法 super(C, self).test() # 调用A类中的test方法 super(A, self).test() # 调用B类中的test方法
C()
# A# A# B(2)场景二
- 2.当我们在子类中使用父类的一个方法并且想对其做一定扩展又不想完全重写,那么使用super()就可以实现方法的增量修改:
- 举一个例子,如果我们想把list中的append的方法改为中文添加应该怎么做呢?
- 并且python中list调用append方法是没有返回值的,我们想在添加元素操作成功后加一个返回值返回成功又该如何操作呢?
- 首先看通过调用原来的list的执行结果
a=list()res=a.append(1)print(res)
# None- 可以看到调用append方法后返回的值为None
- 现在我们通过super进行重写
- 让其具有返回值并可以直接通过中文来调用append:
class 列表(list): def 添加(self, *args, **kwargs): super().append(*args, **kwargs) return "添加成功"
x = 列表()res = x.添加(1)print(res)print(x)
# 添加成功# [1]【4】总结
- super实际上还是很常用的
- 比如在restfremework中
- 需要重写其响应结果的Response信息的时候
- 除了通过django的中间件实现
- 也可以使用super重写其dispatch来实现。
【二十八】查看内存属性(vars)
【1】作用
- vars() 函数返回对象object的属性和属性值的字典对象。
【2】语法
- vars([object])
- object — 对象
【3】返回值
- 返回对象object的属性和属性值的字典对象
- 如果没有参数,就打印当前调用位置的属性和属性值 类似 locals()。
【4】示例
print(vars())
# {'__name__': '__main__', '__doc__': None, '__package__': None, '__loader__': <_frozen_importlib_external.SourceFileLoader object at 0x00000166DE910940>, '__spec__': None, '__annotations__': {}, '__builtins__': <module 'builtins' (built-in)>, '__file__': 'E:\\Old Boy\\day_projects\\day16\\text.py', '__cached__': None}class Runoob: a = 1
print(vars(Runoob))# {'__module__': '__main__', 'a': 1, '__dict__': <attribute '__dict__' of 'Runoob' objects>, '__weakref__': <attribute '__weakref__' of 'Runoob' objects>, '__doc__': None}runoob = Runoob()print(vars(runoob))# {}支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!
相关文章智能推荐
1
C 语言开发环境的安装与配置
编程语言在 Windows、Linux 与 macOS 上安装 C 工具链,配置编辑器,并编译运行第一个 C 程序。
2
C 语言发展史
编程语言了解 C 语言从 BCPL、B 语言到现代标准 C 的发展历程、核心特点与应用领域。
3
C 语言初识:程序运行机制与基本结构
编程语言认识 C 程序从源代码到运行的完整流程,以及基础语法和程序的基本结构。
4
C 语言基础:注释、关键字、变量与数据类型
编程语言学习 C 语言的注释、关键字、标识符、常量、变量和基本数据类型等基础知识。
5
C 语言数据类型
编程语言理解 C 语言的数据类型体系,包括基本类型、整数类型、浮点类型和逻辑类型。
随机文章随机推荐

Dream
Hello, I'm Dream.
欢迎来到我的博客!爱学习爱进步。
文章
300
分类
5
标签
26
总字数
640,882
运行时长
0 天
最后活动
0 天前
站点域名firefly.cuteleaf.cn
Fireflyv6.16.8
Astrov7.3.2
Nodev24.21.0
pnpmv11.22.0
构建时间2026年9月27日 14:40:35
系统信息Linux / x86_64