


C 语言数据类型
【一】数据类型
在 C 语言中,数据类型用于描述数据的性质。一个对象或表达式的类型,会影响以下内容:
- 数据在内存中的表示方式和通常占用的空间;
- 数据能够表示的取值范围与精度;
- 可以对数据执行哪些运算;
- 编译器应当如何解释对应的位模式。
例如,同样一组二进制位,按整数、浮点数或字符解释时,含义可能完全不同。
C 语言的类型可以概括为以下几类:
- 基本类型:包括字符类型、整数类型、布尔类型和浮点类型。
- 枚举类型:使用
enum定义一组具名的整数常量。 - 派生类型:包括数组类型、指针类型和函数类型。
- 结构体与共用体类型:分别使用
struct和union组织多个成员。 void类型:表示“没有值”,常用于无返回值函数和通用对象指针void *。
C 语言没有“引用类型”这一类别。引用是 C++ 等语言中的概念;C 语言主要通过指针间接访问其他对象。
本章以初学阶段最常用的类型为主。除此之外,C99 还提供复数类型,C11 增加了原子类型相关机制,这些内容通常在数学计算和并发编程中进一步学习。
【二】基础数据类型
C 语言的基本类型主要包括:
| 类别 | 常用类型 | 用途 |
|---|---|---|
| 字符类型 | char、signed char、unsigned char | 保存字符编码单元或小整数 |
| 整数类型 | short、int、long、long long 及其无符号形式 | 保存整数 |
| 布尔类型 | _Bool,以及常用写法 bool | 表示逻辑真与假 |
| 浮点类型 | float、double、long double | 保存带小数部分或范围较大的近似数值 |
数据类型的实际大小与取值范围由 C 标准的最低要求、编译器、目标平台和数据模型共同决定,不能简单认为 int 永远为 4 字节、long 永远为 8 字节。
C 标准规定了整数类型的最低精度与相对关系,例如:
sizeof(char) <= sizeof(short) <= sizeof(int) <= sizeof(long) <= sizeof(long long)相邻类型的大小允许相同。sizeof(char) 按定义始终为 1,但 C 语言中的 1 字节不一定等于 8 位;每字节的位数可通过 <limits.h> 中的 CHAR_BIT 查看。现代通用平台通常为 8 位。
可以使用 sizeof 查看当前编译环境中某个类型所占的字节数,并通过以下头文件查询类型范围:
<limits.h>:整数类型的范围和每字节位数;<float.h>:浮点类型的范围与精度;<stdint.h>:固定宽度整数类型及相关宏。
【1】浮点类型
浮点类型用于表示带小数部分或数值范围较大的近似值:
| 类型 | 常见大小 | 常见有效数字 | 字面量示例 |
|---|---|---|---|
float | 4 字节 | 约 6~9 位十进制有效数字 | 3.14f |
double | 8 字节 | 约 15~17 位十进制有效数字 | 3.14 |
long double | 8、12 或 16 字节 | 不低于 double | 3.14L |
表中的大小与精度是现代平台上的常见情况,实际结果仍取决于具体实现。可以使用 sizeof 查看大小,并通过 <float.h> 中的 FLT_DIG、DBL_DIG、LDBL_DIG 等宏查看精度。
浮点数使用有限位数保存数值,很多十进制小数无法被二进制浮点格式精确表示:
#include <stdio.h>
int main(void){ double result = 0.1 + 0.2;
printf("%.17f\n", result); return 0;}常见输出为 0.30000000000000004。因此,判断浮点计算结果是否相等时,通常需要结合业务允许的误差范围,而不能一律直接使用 ==。
【2】void 类型
void 表示“没有值”或“不指定具体对象类型”,主要有以下用途:
void print_message(void); // 函数没有返回值,并且不接收参数void *data; // 可以保存任意对象的地址- 不能定义
void类型的普通变量,因为void没有可存储的值和确定的对象大小。 void *是通用对象指针,可以与其他对象指针相互转换。void *不包含所指对象的具体类型信息,因此不能直接解引用;使用前需要转换或赋给正确类型的对象指针。
【三】逻辑类型
C99 引入了 _Bool 类型。包含 <stdbool.h> 后,在 C17 及更早标准中通常可以使用更易读的 bool、true 和 false;C23 已将 bool、true 和 false 纳入语言本身。
#include <stdbool.h>
bool is_ready = true;bool has_error = false;在条件判断中:
- 数值
0表示假; - 任何非零值都表示真;
- 将任意标量值转换为
_Bool时,0会转换为0,非零值会转换为1。
因此,“非零为真”描述的是条件判断规则,并不表示所有非零值本身都等于整数 1。
例如:
int x;
if (0.5) { x = 12;} else { x = 18;}
// 0.5 是非零值,条件为真,因此 x 最终为 12。浮点数也可以作为判断条件,但实际程序通常应写出含义更明确的比较表达式,例如
value != 0.0。
【四】整数类型
C 的标准整数类型包括 char、short、int、long 和 long long,每种标准有符号整数类型(除 plain char 外)都有对应的无符号形式。
signed char / unsigned charsigned short / unsigned shortsigned int / unsigned intsigned long / unsigned longsigned long long / unsigned long long其中,signed 可以省略,因此 short 等价于 signed short,int 等价于 signed int。但是,char、signed char 和 unsigned char 是三个不同的类型,普通 char 是否带符号由具体实现决定。
下面表格中的字节数和范围是常见 8 位字节、二进制补码环境中的典型结果,并非 C 标准对所有平台的固定要求。编写程序时,可以使用 sizeof 和 <limits.h> 在当前环境中确认。
【1】字符类型(char)
| 类型名称 | 常见长度 | 常见范围 | 说明 |
|---|---|---|---|
char | 1 字节 | 由实现决定 | 与 signed char、unsigned char 都是不同类型 |
signed char | 1 字节 | -128 ~ 127 | 明确表示有符号小整数 |
unsigned char | 1 字节 | 0 ~ 255 | 也常用于查看对象的原始字节 |
给整数类型赋值时,需要注意目标类型能否表示该值:
char c1 = 129;unsigned char c2 = -1;- 如果当前实现的普通
char是有符号的,并且无法表示129,转换结果由实现定义,编译器也可能发出警告;这不一定是编译错误。 - 转换到无符号整数类型时,数值会按该类型可表示值数量取模。在 8 位
unsigned char环境中,-1会转换为255。
不应依赖超出范围后的隐式转换结果来表达正常业务逻辑。需要明确范围时,应先检查数值,再进行转换。
【2】short 类型
| 类型名称 | 常见长度 | 常见范围 |
|---|---|---|
short(signed short) | 2 字节 | -32768 ~ 32767 |
unsigned short | 2 字节 | 0 ~ 65535 |
【3】int 类型
| 类型名称 | 常见长度 | 常见范围 |
|---|---|---|
int(signed int) | 4 字节 | -2147483648 ~ 2147483647 |
unsigned int | 4 字节 | 0 ~ 4294967295 |
【4】long 类型
long 的大小不能仅根据“32 位或 64 位系统”判断,它还取决于平台采用的数据模型:
| 常见环境 | 数据模型 | long 的常见长度 | signed long 的常见范围 |
|---|---|---|---|
| 32 位 Windows / Linux | ILP32 | 4 字节 | -231 ~ 231 - 1 |
| 64 位 Windows(包括 MinGW-w64) | LLP64 | 4 字节 | -231 ~ 231 - 1 |
| 64 位 Linux / macOS | LP64 | 8 字节 | -263 ~ 263 - 1 |
相应的 unsigned long 范围通常为 0 ~ 2N - 1,其中 N 是该类型的位数。
【5】long int 类型
long int 不是另一种独立类型,它只是 long 的完整写法;同理,unsigned long int 与 unsigned long 完全等价。
long a = 10L;long int b = 10L; // 与 long 相同unsigned long c = 10UL;unsigned long int d = 10UL; // 与 unsigned long 相同【6】long long 类型
| 类型名称 | 常见长度 | 常见范围 |
|---|---|---|
long long(signed long long) | 8 字节 | -263 ~ 263 - 1 |
unsigned long long | 8 字节 | 0 ~ 264 - 1 |
long long 从 C99 开始成为标准类型,标准保证它至少能够表示 -9223372036854775807 ~ 9223372036854775807。
【7】注意事项
-
有符号整数发生超出可表示范围的算术溢出时,会产生未定义行为。
-
无符号整数运算按 2N 取模,其中
N是该类型的值位数,因此不会发生标准意义上的有符号溢出,但仍可能造成逻辑错误。 -
float、double和long double没有对应的unsigned形式,下面的写法都是语法错误:unsigned float value1;unsigned double value2;unsigned long double value3; -
需要明确位宽时,可以使用
<stdint.h>中的int8_t、uint32_t、int64_t等类型。只有实现能够提供相应宽度时,这些类型才会被定义。
【五】整数进制
- 按照进位规则计数的数制称为进位计数制,简称进位制。
- C 源代码中的整数字面量可以使用二进制、八进制、十进制和十六进制表示。
- 进制只影响源代码的书写方式,不会改变整数在程序中的类型和值。例如,
10、012和0xA表示的数值都等于十进制的 10。
【1】二进制
基数为 2 的进位制称为二进制。
二进制只有
0、1两种数字,计数时逢 2 进 1。二进制整数字面量以
0b或0B开头,例如0b1010。
0b 前缀从 C23 开始成为标准语法;在更早的 C 标准模式中,它属于 GCC、Clang 等编译器提供的扩展。使用旧版编译器或严格的 C17 模式时,应先确认是否支持。
0b1010 = 1 × 2^3 + 0 × 2^2 + 1 × 2^1 + 0 × 2^0 = 1 × 8 + 0 × 4 + 1 × 2 + 0 × 1 = 10【2】八进制
基数为 8 的进位制称为八进制。
八进制包含
0~7共八种数字,计数时逢 8 进 1。八进制整数字面量以数字
0开头。
01010 = 1 × 8^3 + 0 × 8^2 + 1 × 8^1 + 0 × 8^0 = 1 × 512 + 0 × 64 + 1 × 8 + 0 × 1 = 520注意区分普通十进制数和以
0开头的八进制数。例如,010表示十进制的 8;08和09不是合法的八进制整数字面量。
【3】十进制
基数为 10 的进位制称为十进制。
十进制包含
0~9共十种数字,计数时逢 10 进 1。十进制整数字面量没有额外前缀。
1010 = 1 × 10^3 + 0 × 10^2 + 1 × 10^1 + 0 × 10^0 = 1 × 1000 + 0 × 100 + 1 × 10 + 0 × 1 = 1010【4】十六进制
基数为 16 的进位制称为十六进制。
十六进制包含
0~9和A~F(不区分大小写)共 16 种数字,计数时逢 16 进 1。十六进制整数字面量以
0x或0X开头。
0x1010 = 1 × 16^3 + 0 × 16^2 + 1 × 16^1 + 0 × 16^0 = 1 × 4096 + 0 × 256 + 1 × 16 + 0 × 1 = 4112上述公式中的
^仅用于表示数学上的乘方。在 C 表达式中,^是按位异或运算符,并不表示乘方。
整数的进制与输出格式可以不同。printf 常用的无符号整数格式说明符如下:
| 格式说明符 | 输出形式 |
|---|---|
%u | 无符号十进制 |
%o | 无符号八进制 |
%x | 无符号十六进制(小写) |
%X | 无符号十六进制(大写) |
printf 没有标准的二进制格式说明符。如果需要输出二进制,通常需要自行逐位处理。
【5】练习
(1)进制表示
- 要求:分别使用二进制、八进制、十进制和十六进制字面量表示整数,并统一使用十进制输出。
#include <stdio.h>
int main(void){ int a = 0b1010; // 二进制字面量(C23,旧版 GCC 也支持此扩展) int b = 01010; // 八进制字面量 int c = 1010; // 十进制字面量 int d = 0x1010; // 十六进制字面量
printf("a = %d\n", a); // 以十进制输出 printf("b = %d\n", b); // 以十进制输出 printf("c = %d\n", c); // 以十进制输出 printf("d = %d\n", d); // 以十进制输出
return 0;}- 运行结果
a = 10b = 520c = 1010d = 4112(2)数据类型
- 使用
sizeof运算符查看当前编译环境中常用数据类型占用的字节数。
#include <stdio.h>
int main(void){ printf("sizeof(char) = %zu\n", sizeof(char)); printf("sizeof(unsigned char) = %zu\n", sizeof(unsigned char)); printf("sizeof(short) = %zu\n", sizeof(short)); printf("sizeof(unsigned short) = %zu\n", sizeof(unsigned short)); printf("sizeof(int) = %zu\n", sizeof(int)); printf("sizeof(unsigned int) = %zu\n", sizeof(unsigned int)); printf("sizeof(long) = %zu\n", sizeof(long)); printf("sizeof(unsigned long) = %zu\n", sizeof(unsigned long)); printf("sizeof(long int) = %zu\n", sizeof(long int)); printf("sizeof(unsigned long int) = %zu\n", sizeof(unsigned long int)); printf("sizeof(long long) = %zu\n", sizeof(long long)); printf("sizeof(unsigned long long) = %zu\n", sizeof(unsigned long long)); printf("sizeof(float) = %zu\n", sizeof(float)); printf("sizeof(double) = %zu\n", sizeof(double)); printf("sizeof(long double) = %zu\n", sizeof(long double));
return 0;}sizeof 表达式的结果类型是 size_t,使用 printf 输出时应匹配 %zu,不能使用 %d。
- 运行结果
以下结果用于展示平台差异,不代表所有编译环境都完全相同。
# Windows 10/11,x86_64 MinGW-w64 GCC 13.2.0sizeof(char) = 1sizeof(unsigned char) = 1sizeof(short) = 2sizeof(unsigned short) = 2sizeof(int) = 4sizeof(unsigned int) = 4sizeof(long) = 4sizeof(unsigned long) = 4sizeof(long int) = 4sizeof(unsigned long int) = 4sizeof(long long) = 8sizeof(unsigned long long) = 8sizeof(float) = 4sizeof(double) = 8sizeof(long double) = 16
# Ubuntu 18.04,x86_64 GCC 的一种典型结果sizeof(char) = 1sizeof(unsigned char) = 1sizeof(short) = 2sizeof(unsigned short) = 2sizeof(int) = 4sizeof(unsigned int) = 4sizeof(long) = 8sizeof(unsigned long) = 8sizeof(long int) = 8sizeof(unsigned long int) = 8sizeof(long long) = 8sizeof(unsigned long long) = 8sizeof(float) = 4sizeof(double) = 8sizeof(long double) = 16【六】ASCII 码
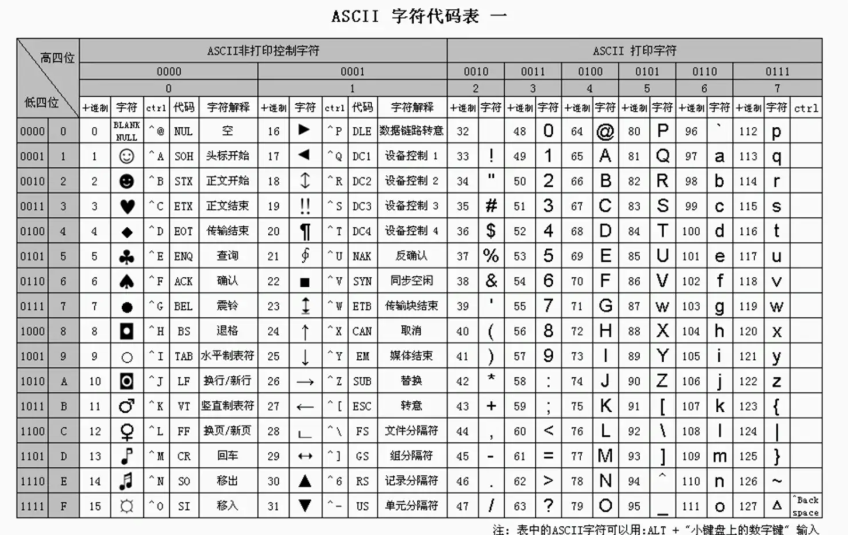
ASCII(American Standard Code for Information Interchange,美国信息交换标准代码)是一种早期且广泛使用的字符编码标准。
ASCII 使用 7 位编码,共定义 128 个码位,范围为十进制 0~127(十六进制 0x00~0x7F)。其中包含英文字母、十进制数字、常用符号和控制字符。
ASCII 的核心作用是建立字符与整数编码值之间的映射。例如,在 ASCII 中,字符 'A' 对应十进制值 65,字符 '0' 对应十进制值 48。
在 C 语言中,char 属于整数类型,因此字符可以参与整数运算,也可以分别按字符形式或整数形式输出:
#include <stdio.h>
int main(void){ char ch = 'A';
printf("字符:%c\n", ch); printf("编码值:%d\n", (int)(unsigned char)ch); return 0;}在 ASCII 环境中,程序会输出字符 A 及其编码值 65。
C 语言标准并不强制执行字符集必须采用 ASCII,但 Windows、Linux 和 macOS 等现代通用环境通常兼容 ASCII 的前 128 个码位。ASCII 之外的中文等字符需要结合 UTF-8、GBK 等字符编码理解,不能简单当作单个
char处理。
ASCII 可以划分为:
0x00~0x1F:32 个控制字符;0x20~0x7E:95 个可打印字符;0x7F:删除控制字符 DEL。
【1】不可打印字符
不可打印字符通常不直接显示图形,而是用于控制文本、终端或通信过程。常见示例如下:
| ASCII 值 | 转义写法 | 名称 | 说明 |
|---|---|---|---|
| 0 | \0 | NUL(空字符) | C 字符串的结束标志 |
| 8 | \b | BS(退格) | 对应退格控制功能 |
| 9 | \t | HT(水平制表) | 移动到下一个水平制表位置 |
| 10 | \n | LF(换行) | Unix/Linux 文本中的换行字符 |
| 13 | \r | CR(回车) | 将位置移至当前行开头;Windows 文本换行通常使用 \r\n |
| 127 | 无常用转义写法 | DEL(删除) | 删除控制字符 |
键盘上的 Enter 键会由终端或操作系统转换成相应的输入序列,并不能在所有环境下简单等同于单个 ASCII 10。
【2】可打印字符
| ASCII 值 | 字符 | 描述 |
|---|---|---|
| 32 | 空格 | 空格字符 ' ' |
| 39 | ' | 单引号;在字符常量中写作 '\'' |
| 47 | / | 正斜杠 |
| 48 | 0 | 数字字符 '0',不要与编码值为 0 的 \0 混淆 |
| 65 | A | 大写英文字母 A |
| 92 | \ | 反斜杠;在 C 字符常量中写作 '\\' |
| 96 | ` | 反引号 |
| 97 | a | 小写英文字母 a |
| 124 | | | 竖线 |
ASCII 中的数字字符和英文字母各自连续排列,因此可以进行一些简单换算:
int digit = '7' - '0'; // 得到整数 7char lower = 'A' + 32; // ASCII 中得到字符 'a'其中,C 标准保证 '0'~'9' 连续,因此第一种数字转换写法具有可移植性;'A' + 32 依赖 ASCII 的字母排列方式。更通用的大小写转换应使用 <ctype.h> 中的 tolower 和 toupper:
#include <ctype.h>
char lower = (char)tolower((unsigned char)'A');char upper = (char)toupper((unsigned char)'a');为了在 Markdown 表格中显示竖线字符,表格中的
|写作\|。这只是 Markdown 转义,不属于字符本身。
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!
