


常用模块之json、pickle模块
2089 字
10 分钟
常用模块之json、pickle模块
【一】序列化和反序列化
【1】什么是序列化
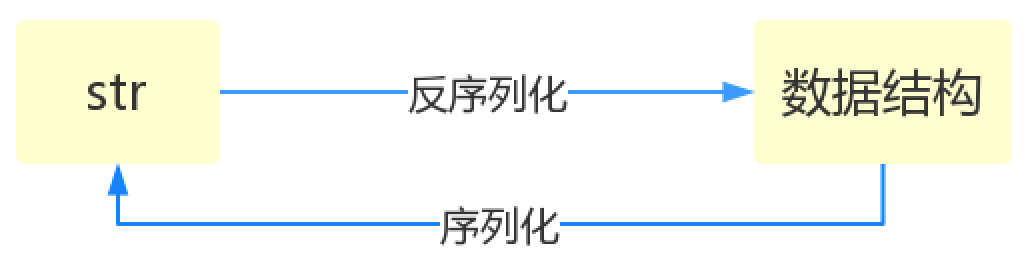
- 将原本的字典、列表等内容转换成一个字符串的过程就叫做序列化。
【2】为什么要有序列化
- 比如,我们在 python代码中计算的一个数据需要给另外一段程序使用,那我们怎么给?
- 现在我们能想到的方法就是存在文件里
- 然后另一个 python 程序再从文件里读出来。
- 但是我们都知道
- 对于文件来说是没有字典这个概念的
- 所以我们只能将数据转换成字典放到文件中。
- 你一定会问,将字典转换成一个字符串很简单,就是str(dic)就可以办到了
- 为什么我们还要学习序列化模块呢?
- 没错序列化的过程就是从dic 变成str(dic)的过程。
- 现在你可以通过str(dic)
- 将一个名为dic的字典转换成一个字符串,
- 但是你要怎么把一个字符串转换成字典呢?
- 聪明的你肯定想到了eval(),如果我们将一个字符串类型的字典str_dic传给eval,就会得到一个返回的字典类型了。
- eval()函数十分强大,但是eval是做什么的?
- 官方demo解释为:
- 将字符串str当成有效的表达式来求值并返回计算结果。
- BUT!强大的函数有代价。安全性是其最大的缺点。
- 想象一下
- 如果我们从文件中读出的不是一个数据结构,
- 而是一句”删除文件”类似的破坏性语句
- 那么后果实在不堪设设想。
而使用eval就要担这个风险。
- 所以
- 我们并不推荐用eval方法来进行反序列化操作(将str转换成python中的数据结构)
【3】序列化的目的
- 以某种存储形式使自定义对象持久化;
- 将对象从一个地方传递到另一个地方。
- 使程序更具维护性。
【二】序列化模块json
【1】导入模块
import json【2】序列化方法(loads)
- 将json字符串转换为Python对象
import json
json_str = '{"name": "Dream", "age": 30, "city": "Shang Hai"}'python_obj = json.loads(json_str)
print(python_obj,type(python_obj))# {'name': 'Dream', 'age': 30, 'city': 'Shang Hai'} <class 'dict'># 注释:将 JSON 字符串解码为 Python 字典【2】反序列化(dumps)
- 将Python对象转换为json字符串
- json转换完的字符串类型的字典中的字符串是由 "" 表示的
import json
python_obj = {"name": "Dream", "age": 30, "city": "Shang Hai"}json_str = json.dumps(python_obj, indent=2)print(json_str, type(json_str))# {# "name": "Dream",# "age": 30,# "city": "Shang Hai"# } <class 'str'>
# 注释:将 Python 字典编码为漂亮格式的 JSON 字符串【3】写入文件(dump)
(1)不指定参数
- 接收一个文件句柄
- 直接将字典 转换成 json字符串 写入文件
import json
python_obj = {"name": "John", "age": 30, "city": "New York"}with open("data.json", "w") as json_file: # indent : 控制缩进的空格数或字符串 json.dump(python_obj, json_file, indent=2)
# 注释:将 Python 字典写入 JSON 文件- 会在本地生成一个 data.json 的文件在里面有上面写入的数据
(2)指定参数编码(ensure_ascii)
import json
python_obj = {"name": "蚩梦", "age": 30, "city": "Shang Hai"}# 写文件时指定编码格式为 utf-8 ---> 这样在json文件中存储的中文才是正常的中文,否则是二进制数据with open("data.json", "w",encoding='utf-8') as json_file: # ensure_ascii=False 上面指定编码格式后需要将 默认使用 ascii 这个选项设置为否 json.dump(python_obj, json_file, indent=2,ensure_ascii=False)
# 注释:将 Python 字典写入 JSON 文件# 未指定 encoding='utf-8'{ "name": "\u86a9\u68a6", "age": 30, "city": "Shang Hai"}
# 指定 encoding='utf-8'{ "name": "蚩梦", "age": 30, "city": "Shang Hai"}(3)指定参数分隔符(separators)
import json
python_obj = {"name": "蚩梦", "age": 30, "city": "Shang Hai"}with open("data.json", "w", encoding='utf-8') as json_file:
# 将默认的分隔符 , 替换成我们的指定分隔符 - # 将默认的分隔符 : 替换成我们的指定分隔符 ; json.dump(python_obj, json_file, indent=2, ensure_ascii=False, separators=(',', ';'))
# 注释:将 Python 字典写入 JSON 文件{ "name";"蚩梦"- "age";30- "city";"Shang Hai"}(4)其他参数
Serialize obj to a JSON formatted str.(字符串表示的json对象)
Skipkeys: 默认值是False 如果dict的keys内的数据不是python的基本类型(str,unicode,int,long,float,bool,None)设置为False时,就会报TypeError的错误。 此时设置成True,则会跳过这类key
ensure_ascii: 当它为True的时候 所有非ASCII码字符显示为\uXXXX序列 只需在dump时将ensure_ascii设置为False即可 此时存入json的中文即可正常显示。
If check_circular is false, then the circular reference check for container types will be skipped and a circular reference will result in an OverflowError (or worse).If allow_nan is false, then it will be a ValueError to serialize out of range float values (nan, inf, -inf) in strict compliance of the JSON specification, instead of using the JavaScript equivalents (NaN, Infinity, -Infinity).
indent: 应该是一个非负的整型 如果是0就是顶格分行显示 如果为空就是一行最紧凑显示 否则会换行且按照indent的数值显示前面的空白分行显示 这样打印出来的json数据也叫pretty-printed json
separators: 分隔符 实际上是(item_separator, dict_separator)的一个元组 默认的就是(‘,’,’:’); 这表示dictionary内keys之间用“,”隔开 而KEY和value之间用“:”隔开。
default(obj) is a function that should return a serializable version of obj or raise TypeError. The default simply raises TypeError.
sort_keys: 将数据根据keys的值进行排序。
To use a custom JSONEncoder subclass (e.g. one that overrides the .default() method to serialize additional types), specify it with the cls kwarg; otherwise JSONEncoder is used.【4】读文件数据(load)
- 接收一个文件句柄
- 直接将文件中的 json字符串 转换成 数据结构返回
import json
# 可以选择指定读取数据的默认编码格式with open("data.json", "r",encoding='utf-8') as json_file: python_obj = json.load(json_file) print(python_obj, type(python_obj)) # {'name': '蚩梦', 'age': 30, 'city': 'Shang Hai'} <class 'dict'>
# 注释:从 JSON 文件中读取数据并转为 Python 字典- 会从 data.json 中将数据读出来并转换为Python字典
【三】序列化模块pickle
- json & pickle 模块 (用于序列化的两个模块)
- json
- 用于字符串 和 python数据类型间进行转换
- pickle
- 用于python特有的类型 和 python的数据类型间进行转换
【1】序列化方法(dumps)
import pickle
dic = {'k1': 'v1', 'k2': 'v2', 'k3': 'v3'}str_dic = pickle.dumps(dic)print(str_dic)# b'\x80\x04\x95#\x00\x00\x00\x00\x00\x00\x00}\x94(\x8c\x02k1\x94\x8c\x02v1\x94\x8c\x02k2\x94\x8c\x02v2\x94\x8c\x02k3\x94\x8c\x02v3\x94u.'print(type(str_dic))# <class 'bytes'>【2】反序列化方法(loads)
import pickle
dic = {'k1': 'v1', 'k2': 'v2', 'k3': 'v3'}str_dic = pickle.dumps(dic)print(str_dic)# b'\x80\x04\x95#\x00\x00\x00\x00\x00\x00\x00}\x94(\x8c\x02k1\x94\x8c\x02v1\x94\x8c\x02k2\x94\x8c\x02v2\x94\x8c\x02k3\x94\x8c\x02v3\x94u.'print(type(str_dic))# <class 'bytes'>
dic2 = pickle.loads(str_dic)print(dic2)# {'k1': 'v1', 'k2': 'v2', 'k3': 'v3'}print(type(dic2))# <class 'dict'>【3】写入文件(dump)
import pickleimport time
struct_time = time.localtime()print(struct_time)# time.struct_time(tm_year=2023, tm_mon=11, tm_mday=25, tm_hour=20, tm_min=9, tm_sec=46, tm_wday=5, tm_yday=329, tm_isdst=0)
# 打开文件,并将句柄给 ff = open('pickle_file', 'wb')# 向 pickle_file 文件中写入数据pickle.dump(struct_time, f)# 完成写入,关闭文件f.close()- 写入到 pickle_file 文件里面的数据是一堆乱码,看不懂
€昫 ?time攲
struct_time敁?M?K K K K.K(KK麷 t攠??tm_zone攲涓浗鏍囧噯鏃堕棿攲 tm_gmtoff擬€pu啍R?【4】读文件数据(load)
import pickle
# 打开文件的句柄f = open('pickle_file', 'rb')# 将读出来的数据给 struct_time2struct_time2 = pickle.load(f)
# 我们可以直接操作 struct_time2 --- 上面直接写入的时间元组对象print(struct_time2)# time.struct_time(tm_year=2023, tm_mon=11, tm_mday=25, tm_hour=20, tm_min=9, tm_sec=46, tm_wday=5, tm_yday=329, tm_isdst=0)
print(type(struct_time2))# <class 'time.struct_time'>print(struct_time2.tm_year)# 2023【5】小练习
- 将Python特有的函数写入文件
import pickle
def index(): print(f" 这是index 函数")
# 将函数对象写入文件with open('my_func', 'wb') as f: print(index) # <function index at 0x0000024D28D03E20> pickle.dump(index, f)- 将Python特有的函数对象在文件中读出来并调用
import pickle
def index(): print(f" 这是index 函数")
# 将函数对象写入文件with open('my_func', 'rb') as f: data = pickle.load(f) print(data) # <function index at 0x0000027D9C893E20> data() # 这是index 函数【四】小结
- 这时候机智的你又要说了,既然pickle如此强大,为什么还要学json呢?
- 这里我们要说明一下
- json是一种所有的语言都可以识别的数据结构。
- 如果我们将一个字典或者序列化成了一个json存在文件里
- 那么java代码或者js代码也可以拿来用。
- 但是如果我们用pickle进行序列化
- 其他语言就不能读懂这是什么了~
- 所以,如果你序列化的内容是列表或者字典,我们非常推荐你使用json模块
- 但如果出于某种原因你不得不序列化其他的数据类型,而未来你还会用python对这个数据进行反序列化的话,那么就可以使用pickle
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!
相关文章智能推荐
1
C 语言发展史
编程语言了解 C 语言从 BCPL、B 语言到现代标准 C 的发展历程、核心特点与应用领域。
2
C 语言开发环境的安装与配置
编程语言在 Windows、Linux 与 macOS 上安装 C 工具链,配置编辑器,并编译运行第一个 C 程序。
3
C 语言初识:程序运行机制与基本结构
编程语言认识 C 程序从源代码到运行的完整流程,以及基础语法和程序的基本结构。
4
C 语言基础:注释、关键字、变量与数据类型
编程语言学习 C 语言的注释、关键字、标识符、常量、变量和基本数据类型等基础知识。
5
C 语言数据类型
编程语言理解 C 语言的数据类型体系,包括基本类型、整数类型、浮点类型和逻辑类型。
随机文章随机推荐

Dream
Hello, I'm Dream.
欢迎来到我的博客!爱学习爱进步。
文章
300
分类
5
标签
26
总字数
640,882
运行时长
0 天
最后活动
0 天前
站点域名firefly.cuteleaf.cn
Fireflyv6.16.8
Astrov7.3.2
Nodev24.21.0
pnpmv11.22.0
构建时间2026年9月27日 14:40:34
系统信息Linux / x86_64